

Visueel uitgelegd


Modellen maken
De wereld is complex. Daarom is de structuur (wie, wat, waar) van veel bedrijven complex. Daarom zijn de processen (hoe en in welke volgorde) in veel bedrijven complex. Wanneer managers nadenken en overleggen over problemen in bedrijven, vallen zij daarom graag terug op schema's. Een duidelijke figuur kan de complexe structuur en de processen van een bedrijf op een overzichtelijke manier samenvatten. Alle soorten tekeningen die de structuur of processen van een bedrijf beschrijven, kunnen we modellen noemen. Ik spits me vooral toe op de procesmodellen: de tekeningen die een reeks gevolgde of te volgen handelingen beschrijven. Om correct te zijn, moet ik opmerken dat een model eigenlijk gelijk welke voorstelling van de werkelijkheid is en dat dit dus evengoed een tekst kan zijn. Maar meestal gaat het om een grafische voorstelling.

Modellen genereren
Ik zei het al. De wereld is complex. Daarom is de structuur van veel bedrijven complex. Daarom zijn de processen in veel bedrijven complex. En daarom zijn veel procesmodellen verkeerd. Ze zijn niet compleet, niet up-to-date en soms gewoonweg fout. Dat komt omdat deze modellen dikwijls door mensen gemaakt worden en mensen maken nu eenmaal dikwijls fouten in complexe situaties (ik toch). Daarom heeft men een techniek bedacht om procesmodellen automatisch te laten opbouwen door een computerprogramma. Zo wil men sneller juistere en volledigere procesmodellen kunnen genereren. Deze techniek heet process mining. Veel computerprogramma's houden informatie bij over wat ze zoal uitspoken. Deze informatie kan nuttig zijn om achteraf te achterhalen waar iets misliep. Maar deze informatie kunnen wij ook handig gebruiken om te achterhalen wat er gebeurde en in welke volgorde. Daar maken we dan nog een mooi tekeningetje van en zo creëren we een procesmodel.

Uit logbestanden
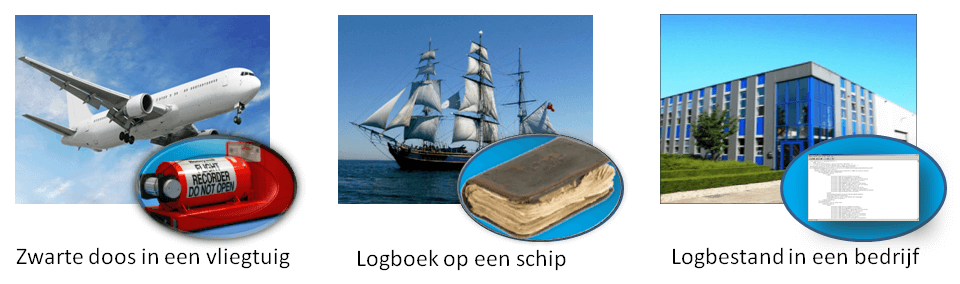
De bestanden waarin computerprogramma's dergelijke informatie bijhouden ('loggen'), worden computerlogboeken genoemd. Het werkt net zoals de zwarte doos in een vliegtui of het logboek op een schip waar de kapitein af en toe de toestand van het schip in schrijft en waar zeker ook alle incidenten neergeschreven worden. Zo houden computerprogramma's bij wat ze doen en zeker ook wat er misloopt. Meestal bevat die informatie een tijdstip, een gebruikersnaam en een melding.

Hoe werkt het?
Laat me een tip van de sluier oplichten over hoe process mining te werk gaat. Hoe wordt de informatie uit logboeken omgezet naar een procesmodel? Wel, je moet je realiseren dat een proces normaal meerdere keren uitgevoerd wordt. Bij een schip gaat dit over iedere tocht, bij een verkoopsproces gaat dit over iedere verkoop, bij een sollicitatieproces gaat dit over iedere sollicitatie en ga zo maar verder. In die logboeken vinden we dan ook meestal meerdere keren dezelfde volgorde van stappen terug (van haven verlaten tot haven binnenvaren, van offerte tot betaling van factuur inboeken, van vacature uitschrijven tot de eerste werkdag van een nieuwe werknemer). Op die manier achterhalen wij de vaste volgorde van stappen in een proces en maken we een tekening met per stap een blokje en dan pijlen van het ene naar het andere blokje. Merk op dat we zoeken naar terugkerende volgordes van stappen, zonder dat we hoeven te weten wat de stappen betekenen.
Soms zien we dat bij de ene uitvoering de stappen in een bepaalde volgorde verlopen en de andere keer lopen enkele stappen anders of in een andere volgorde. Maar als telkens één van beide wegen wordt doorlopen, kunnen we dat ook weer mooi aanduiden in onze tekening. We tekenen dan gewoon meerdere routes van start naar einde. Soms zijn er echt uitzonderingen en moeten wij ons afvragen of we ze wel willen opnemen in onze tekening. Soms zijn er ook gewoon fouten bij het neerschrijven van de gebeurtenissen en dan moeten wij ervoor proberen zorgen dat dit onze tekening niet beïnvloedt. Dit zijn slechts enkele, maar wel belangrijke aandachtspunten in het onderzoek naar process mining...

Logbestanden combineren
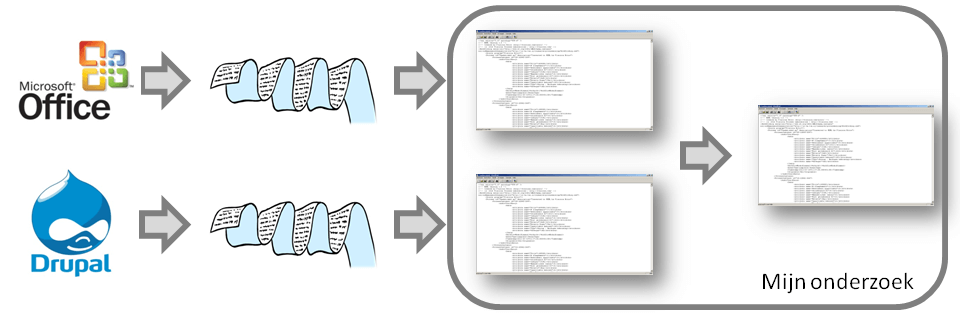
>Niet alles in een bedrijf gebeurt met hetzelfde computerprogramma. Een offertemail stuur je niet met hetzelfde programma als waarmee je de factuur boekt. De factuur opmaken gebeurt dan weer met nog een ander programma. Doordat de verschillende stappen in een proces meestal door verschillende computerprogramma's ondersteund worden, zal je waarschijnlijk zelden in één logboekbestand alle nodige informatie vinden. Natuurlijk is er de trend om zoveel mogelijk te integreren binnen één systeem. Sommige softwarepakketten bieden een enorme waaier aan mogelijkheden (ik denk bijvoorbeeld aan SAP). Toch zullen er altijd stappen zijn die door een ander programma gelogd worden (ik denk bijvoorbeeld aan mails sturen?) en sommige stappen zullen waarschijnlijk helemaal niet door een computerprogramma gelogd worden (bijvoorbeeld een telefoongesprek?). Om toch het maximum uit onze techniek te halen, heb ik technieken ontwikkeld die de informatie van verschillende logboeken (uit verschillende computerprogramma's dus) combineren om een volledig(er) procesmodel te kunnen samenstellen.

Uitdagingen
Natuurlijk is dit niet evident. Er is geen vaste manier om computerlogboeken te maken en de logboeken worden ook niet gemaakt met als doel het samenstellen van procesmodellen. Ieder computerprogramma logt op zijn eigen manier, met zijn eigen accenten, met zijn eigen doelstellingen en dus ook met andere informatie. Het samenbrengen van deze informatie uit verschillende bronnen is een moeilijke klus. Niet alleen gebruiken de verschillende computerprogramma's waarschijnlijk een andere naam voor hetzelfde (bv. user, gebruiker, verantwoordelijke, ...), de mogelijkheid bestaat dat ze op verschillende niveaus loggen (bv. in het ene programma staat dat een account werd aangemaakt, in het andere programma wordt een gebruikersnaam toegewezen, krijgt die gebruiker een paswoord, een mailadres, enzovoort). De informatie kan ook gedeeltelijk of volledig overlappen (bv. de betaling van een factuur vind je terug in de boekhouding, maar ook op rekeninguittreksels).

Video's


